La plupart des discussions sur les agents de code IA partent du principe qu’on en choisit un. En pratique, quand on travaille avec des agents toute la journée, ce n’est pas le cas : on prend celui qui convient à la tâche du moment et, de plus en plus, on les fait tourner en même temps sur le même projet. Voici à quoi cela ressemble vraiment.
// // multi-éditeurs
Claude Code et Codex, côte à côte
Vous ne misez pas sur un éditeur, vous choisissez un outil
Traiter « Claude Code contre Codex » comme une question de fidélité est une erreur de catégorie. Ce sont des outils qui ne se manient pas de la même façon, et la question intéressante n’est pas de savoir lequel gagne. C’est de savoir lequel prendre, et quand. Au bout d’un certain nombre de sessions, on acquiert le réflexe, comme on sait quand écrire un script plutôt que faire les choses à la main.
En gros, cela se répartit ainsi : un agent hérite des tâches que vous pouvez décrire nettement et que vous voulez voir exécutées, l’autre du travail où vous préférez qu’il reste plus longtemps avec l’ambiguïté avant de toucher à quoi que ce soit. Lequel fait quoi dépend du jour, des versions des modèles et de vos propres préférences. Et cela évolue à mesure que les deux outils changent.
L’enjeu n’est pas un classement figé. C’est qu’en ayant les deux sous la main, vous n’imposez jamais le mauvais outil à une tâche simplement parce que c’est le seul ouvert.
Les deux sur une même base de code
Le geste vraiment utile, c’est le parallélisme entre éditeurs. Confiez la couche API à un agent et les tests à un autre. Laissez l’un rédiger une migration pendant que l’autre avance sur les changements d’interface qui en dépendent. Faites tourner deux agents du même éditeur et un de l’autre, et arrêtez de penser « mes sessions Claude » et « mes sessions Codex ». Ce sont juste vos agents, au travail.
C’est là que la dépendance à un éditeur se fait vraiment sentir, et pas au sens habituel. Le problème n’est pas de ne plus pouvoir changer plus tard. C’est qu’un outil mono-éditeur ne peut vous montrer que la moitié de votre flotte à la fois. Si votre vue de statut ne comprend que Claude, les deux sessions Codex en cours lui sont invisibles, et vous revoilà à passer d’onglet en onglet pour les vérifier. Une vue unifiée ne fonctionne que si elle est indépendante des éditeurs dès la base, avec un détecteur par CLI qui alimente une seule grille.
C’est ainsi que vord est construit. Il fait tourner cinq CLI d’agents dans le même cockpit : Claude Code, Codex, Kimi, OpenCode et Grok. Vous les installez et les lancez vous-même ; vord héberge les sessions et lit leur statut. Cet article s’en tient aux deux dont on parle le plus, mais rien ici ne leur est propre.
Le problème de coordination dont personne ne vous parle
Deux agents dans le même dépôt peuvent se marcher dessus. Tous deux décident de modifier le même fichier. Tous deux pensent être seuls à travailler. Vous finissez par arbitrer un merge entre deux de vos propres agents, ce qui est une façon franchement étrange de passer un après-midi.
Il n’existe pas de remède miracle, mais il y a une vraie parade : dites à chaque agent, dans son prompt, qu’il n’est pas seul. Une phrase comme « deux autres agents travaillent en ce moment sur ce projet » change la façon dont un agent raisonne sur son périmètre. Il devient plus prudent avec les changements d’envergure et reste plus volontiers dans son couloir. Cela n’élimine pas les conflits, mais cela réduit ceux, pleins d’assurance et d’inconscience, où un agent réécrit un fichier sous le nez d’un autre parce qu’il ignorait qu’il y avait quelqu’un.
L’autre moitié vous revient : donnez-leur des tâches disjointes. Le parallélisme est sûr quand les agents ont chacun leurs fichiers ou leurs responsabilités. Dès que deux agents modifient la même zone, vous avez retransformé un travail parallèle en travail séquentiel, avec des conflits en prime. Découpez la tâche pour que les jointures entre agents tombent sur de vraies frontières.
Le flux de travail, concrètement
Voici ce que cela donne dans un outil qui le permet :
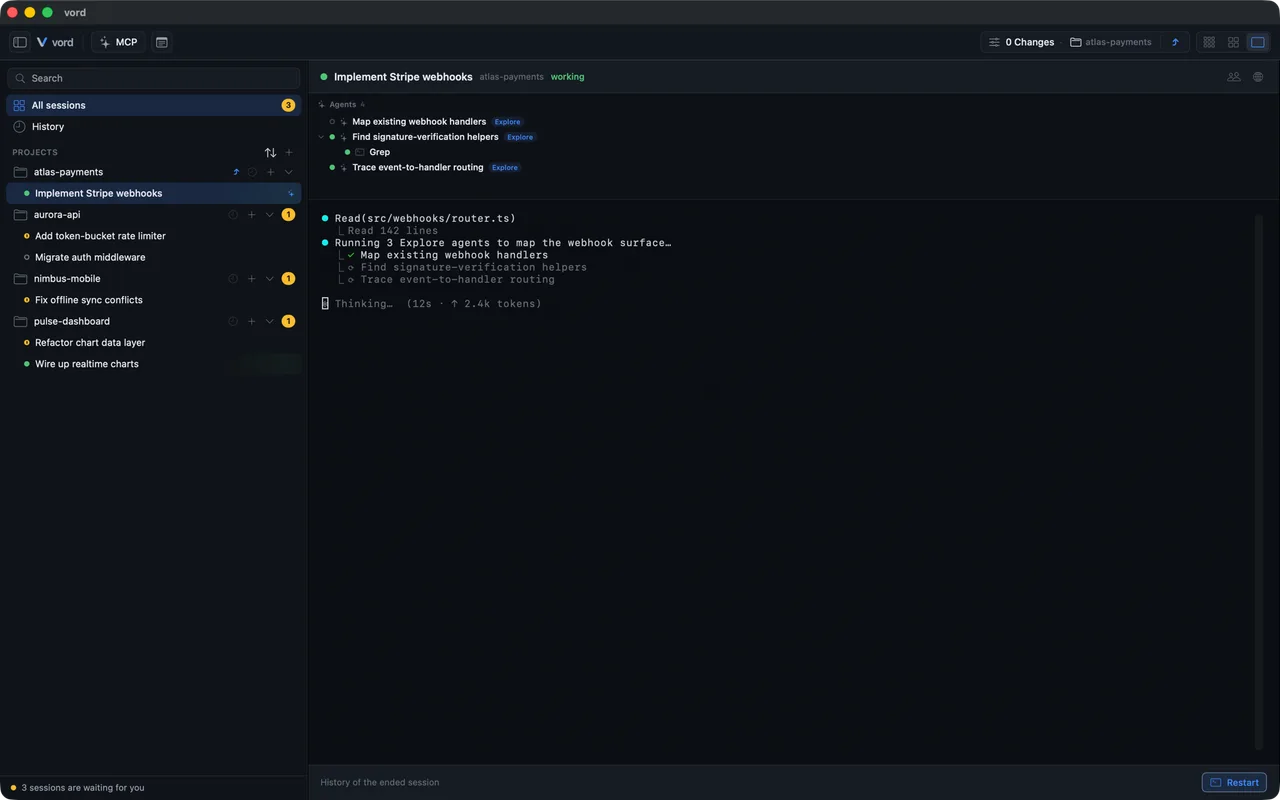
Une grille, les deux éditeurs. Sessions Claude Code et Codex dans la même vue, avec les mêmes statuts, les attentes en premier. Vous ne passez pas d’une app à l’autre pour voir les deux moitiés de votre travail.
MCP géré pour les deux. Les serveurs MCP qu’utilisent vos agents sont gérés au même endroit, pour Claude comme pour Codex, via leurs CLI officielles : les capacités sont cohérentes au lieu d’être configurées deux fois.
Un statut qui fait la différence. Chaque CLI a son propre détecteur en coulisse, fondé sur les hooks quand la CLI les prend en charge, sur la lecture d’écran sinon. Tous aboutissent aux mêmes statuts, si bien que la grille se lit de la même façon quel que soit l’agent qui tourne.
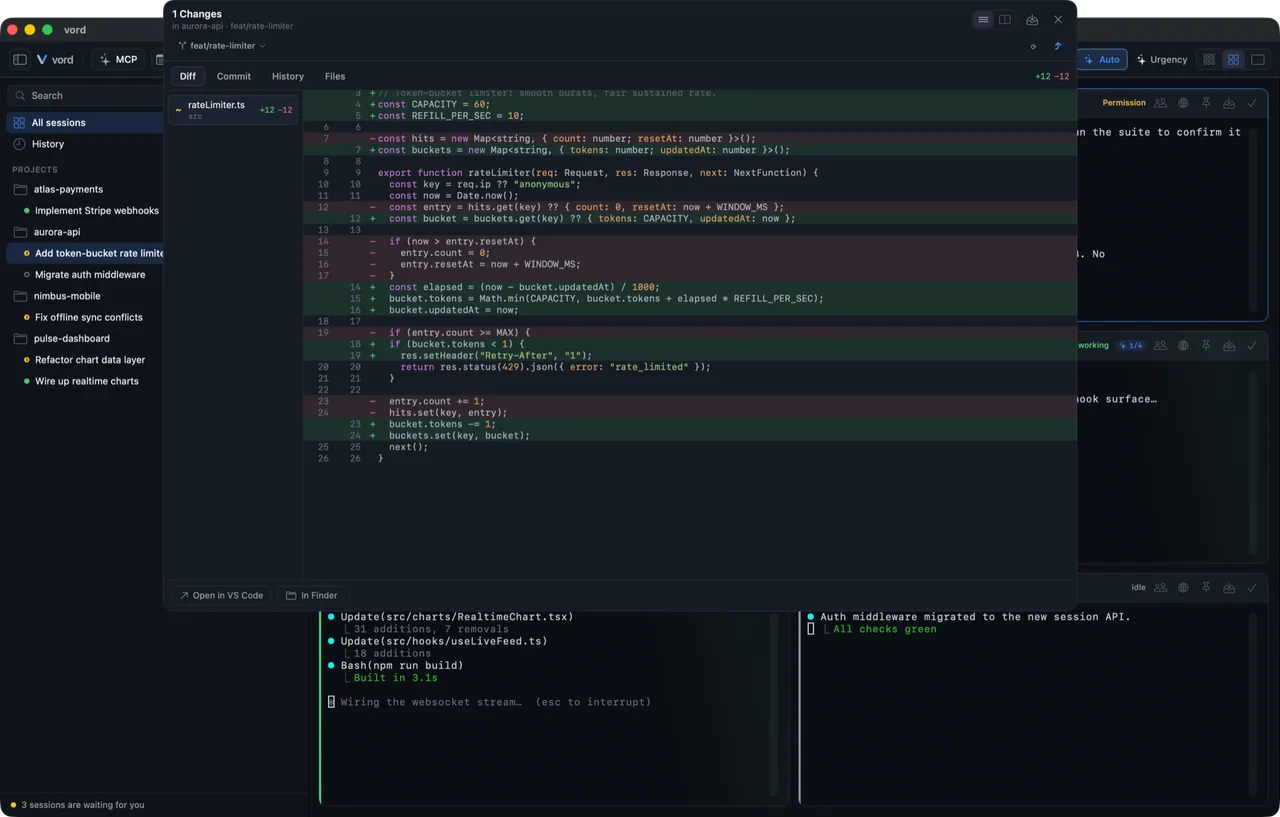
Une relecture au même endroit. Quand l’un ou l’autre termine, le même inspecteur git vous montre le diff. Vous vérifiez le travail de Claude et celui de Codex de la même manière.
une grille
Claude Code et Codex, dans la même vue
Les deux éditeurs, une grille de statut. Les sessions Claude et Codex partagent les mêmes statuts, tout comme Kimi, OpenCode et Grok. Tout ce qui vous attend est en haut, quelle que soit la CLI d’origine.
- Chaque CLI a son propre détecteur ; tous alimentent une seule grille.
- Serveurs MCP de Claude et Codex gérés au même endroit, via leurs CLI officielles.
- Le statut se lit partout pareil : en cours, vous attend, inactive, terminée, limite d’utilisation.
relecture
Vérifiez le travail, quel que soit son auteur
Quand un agent termine, que ce soit Claude ou Codex, le même inspecteur git vous montre le diff et vous permet d’indexer et de commiter depuis là. Vous ne changez pas d’outil pour relire des éditeurs différents.
La limite, en toute honnêteté
Faire tourner les deux ne double pas votre production, et ce n’est pas gratuit. Cela double les décisions et les diffs à lire, et ajoute le risque que deux agents entrent en collision. Cela vaut le coup quand le travail se découpe vraiment en morceaux indépendants et que vous disposez d’une vue qui montre les deux éditeurs comme une seule flotte.
Si vous imposez le parallélisme à un travail qui est en réalité séquentiel, vous le sentirez comme une friction, pas comme un gain de vitesse.
Mais quand le travail se découpe, et c’est souvent le cas, avoir Claude Code et Codex côte à côte dans une seule grille, surveillés par un seul moteur de statut, rend la journée nettement meilleure que de basculer sans cesse entre deux outils qui ne voient chacun que leur moitié.
// // à lire aussi
Continuer la lecture
Faites tourner Claude Code et Codex dans une seule grille
vord fait tourner les deux dans un cockpit Mac natif, avec Kimi, OpenCode et Grok. Les sessions se trient avec les attentes en premier : vous voyez toujours qui attend une décision.